1.提出问题?
视频理解任务五花八门(动作识别、时空定位、目标跟踪、指称分割……),传统专用模型泛化差;LLM 推理能力强,但怎么和视频结合、有哪些路线,当时没人系统整理过。
2.解决问题
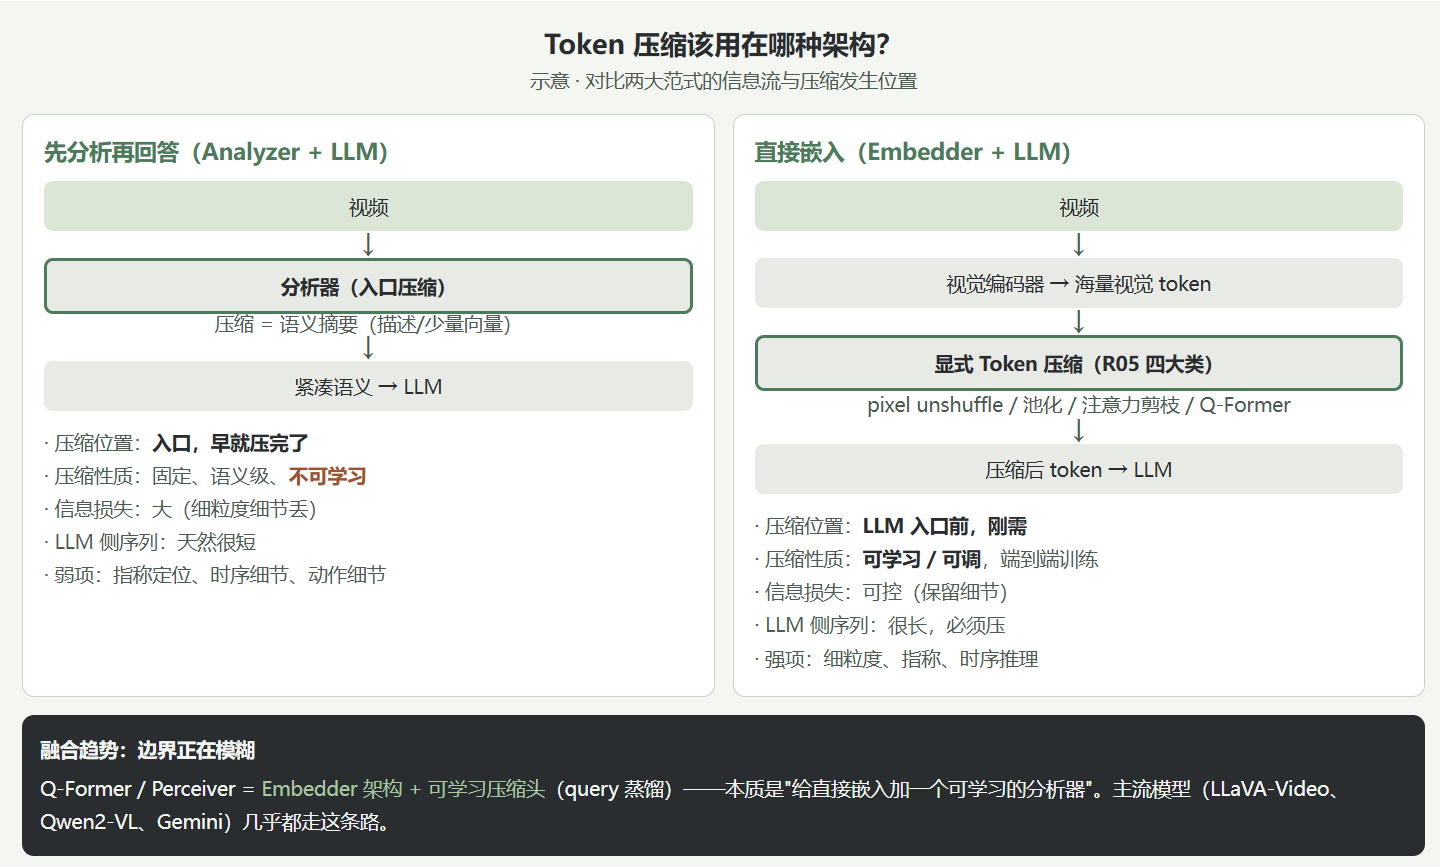
提出三大架构范式 ——Video Analyzer + LLM(先分析再问答)、Video Embedder + LLM(直接嵌入)、混合架构;按任务类型梳理对应数据集与评估指标(f-mAP、video-mAP、HOTA 等)。
3.成果
这套三大范式的分类法成了领域通用的坐标原点,后续工作基本都在这个框架里定位。
4.启发
懂得了长视频理解大语言模型的架构,一共3种架构,我感觉先分析再回答的架构不怎么适合做token压缩,不如直接嵌入的压缩token。