1,提出问题?
已有视频基准要么只测短视频片段(几秒到 3 分钟),要么 "名义上是长视频、实际看一小段就能答";且现代 LLM 先验知识太强,很多题不看视频也能蒙对。怎么设计一套真正需要跨时间片段综合推理、且排除语言先验作弊的小时级评测。
2.解决问题?
任务套件:4 大任务、18 个子任务 ——Summarization(时序排序 / 关键事件 / 对比)、Perception(事实回忆 / 序列回忆 / 时间距离 / 跟踪)、Visual Reasoning(空间 / 时间 / 预测 / 因果 / 反事实)、Navigation(房间到房间 / 物体检索)。每个子任务都用手工设计的 "问题原型" 保证答案必须跨多个时间片段才能得出。
五阶段数据管线(800+ 小时人力):
① 人工筛选视频(1470→500);② LLM 生成题目(25 个任务专属 prompt,20 分钟分段 + 结构化叙述);③ 人工反馈修正(7 人,400+ 小时,修正错误答案和噪声叙述);④ 盲过滤:用两个不看视频的 LLM(GPT-4/GPT-4-turbo)试答,能答对的题全部删除;⑤ 专家精修(4 人,300+ 小时)。
因果 / 反事实 / 布局 / 导航类题目发现 LLM 生成质量不行,改由专家纯手工生成(658 题)。
3.成果
规模碾压同类:平均时长 45.7 分钟,是当时最大长视频 benchmark EgoSchema(3 分钟)的 15 倍;381 小时视频、113 个超 1 小时。
盲 LLM 只有 19.6%,证明题目确实 "必须看视频才能答"—— 防作弊设计有效。
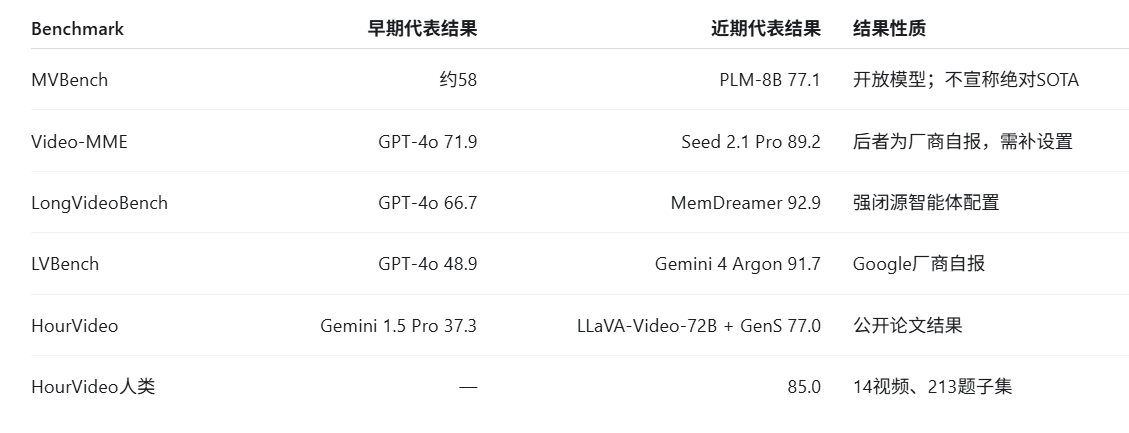
Gemini 1.5 Pro 全面领先 Socratic 方法(37.3% vs 25.7%),但预测、因果、反事实、导航类任务几乎全崩(多数低于或接近随机),人类在四类任务上均达 82–87%。
评测消融:任务级批量评测(38.9%)比逐题独立评测(36.8%)只掉 2.1%,但成本省 3 倍,验证了评测协议的高效性。
4.启发
论文自己在 Limitations 里承认 —— 没有音频模态、缺乏体育 / YouTube 等多样视频源。