1.提出问题?
当时的视频 MLLM(VideoChat、Video-LLaMA、Video-ChatGPT 等)都只能处理几十到一百帧的短视频,长视频有三座大山:
算力 / 显存爆炸:视频每多一帧,就要多喂一组 token,前人的方法每帧要占 25MB~227MB 显存,1 万帧根本放不下;
长期时序连接弱:模型只能看到眼前几秒,记不住 30 分钟前发生了什么,无法做跨场景推理;
没有标准基准:当时没有专门评估 "一分钟以上长视频理解" 的测试集。
2.解决问题?
① 两级记忆 + 滑动窗口(核心贡献)
用 EVA-CLIP(ViT-G/14)逐帧提特征,每帧 32 个 token;
滑窗(16 帧)切块后按顺序喂进短期记忆(容量 18 帧 × 32 tokens),短期记忆用 FIFO 队列管理:装满了就把最旧的弹出去。
② 记忆整合(Memory Consolidation)—— 无参数的 "帧合并" 弹出去的帧不是直接扔进长期记忆,而是先做压缩:反复找出最相似的相邻两帧,按余弦相似度加权平均合并(就是 Algorithm 1 那个循环),直到 18 帧压成 2 个代表帧。这 2 帧同时做两件事:进长期记忆、并重新初始化短期记忆(相当于把上一段的 "记忆" 带进下一段,实现窗口间信息传递)。这个算法 parameter-free,可像插件一样插进任何帧式编码器。
③ 长期记忆(256 帧容量) 所有整合出来的代表帧按时间顺序存进长期记忆,避免灾难性遗忘—— 回答 "整部电影讲了什么" 就靠它。位置编码不够长就用分层分解位置编码(BERT 式)扩展到 n²。
④ 两种推理模式
Global 模式:只用长期记忆 L → 回答整段视频层面的问题;
Breakpoint 模式:L + 短期记忆 S + 当前帧 → 回答 "此时此刻发生了什么" 的问题(事件有连续性,所以两个记忆都要用)。
最终表示过 Q-Former(可学习的二级压缩)→ 投影层 → 送入 LLM 对话。
3.成果
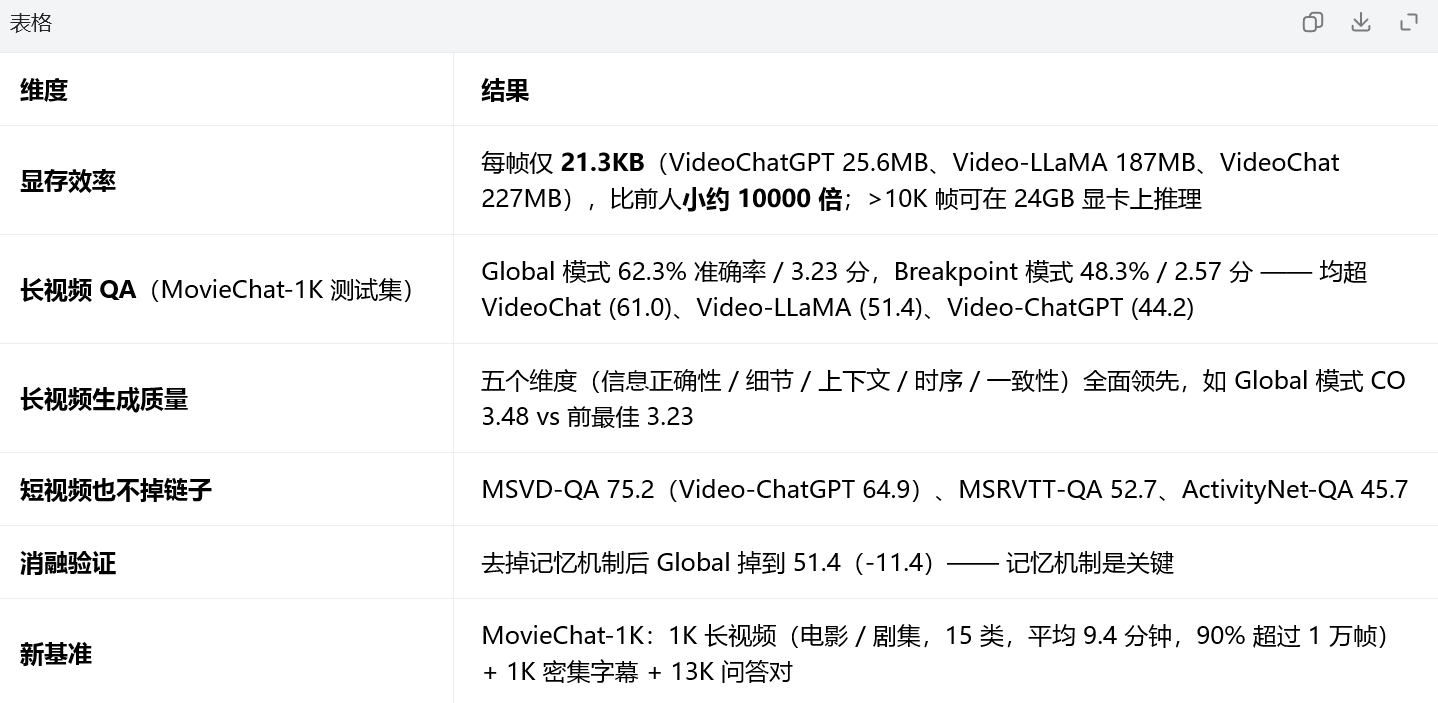
4.启发
它是embedder 压缩" 路线的经典实证。MovieChat 全程没有 "先分析再回答" 的 analyzer—— 它赌的就是Transformer token 嵌入已经是帧的语义摘要,直接拿余弦相似度做合并。你在前面问 "先分析再回答的架构不适合做 token 压缩,不如直接嵌入压缩 token"——MovieChat 就是站你这边的一个证据(无参数、可插拔、效果好)。
但它也暴露了纯 embedder 路线的天花板:作者自己承认两大局限 ——感知能力受限于预训练短视频模型、时间推理很粗糙(只能估算事件占时长比例,定位不准)。后来者正是踩着这两个痛点改进的:MemDreamer(LVBench 90.7)用分层图记忆 + 检索工具把 "记忆" 升级成 "可查询的记忆库";HourVideo 则把评测维度拉满(因果 / 反事实 / 导航),专门惩罚 "记不住细节" 的模型。你的研究线可以这么看:MovieChat(启发式合并记忆)→ MemDreamer(可学习图记忆)→ 下一步是 "可学习 + 可定位时间" 的记忆。
Q-Former 的位置值得玩味:MovieChat 是两级压缩—— 先无参数启发式合并(丢帧冗余),再用可学习 Q-Former(提炼语义)。这说明纯启发式合并不够,最后还是要一个可学习压缩器兜底。这正好接上你问过的 R05 综述里 "基于注意力的 token 压缩"——Q-Former 就是它的工程实例。
Benchmark 谱系又多了一格:MovieChat-1K(9.4 分钟 / 电影类,2024)→ LVBench(68 分钟,2024)→ HourVideo(45.7 分钟 / Ego4D 第一人称,2024)—— MovieChat-1K 是最早的 "长视频 QA" 之一,虽然时长最短,但它是第一个敢叫板 "分钟级" 的。