1.提出问题?
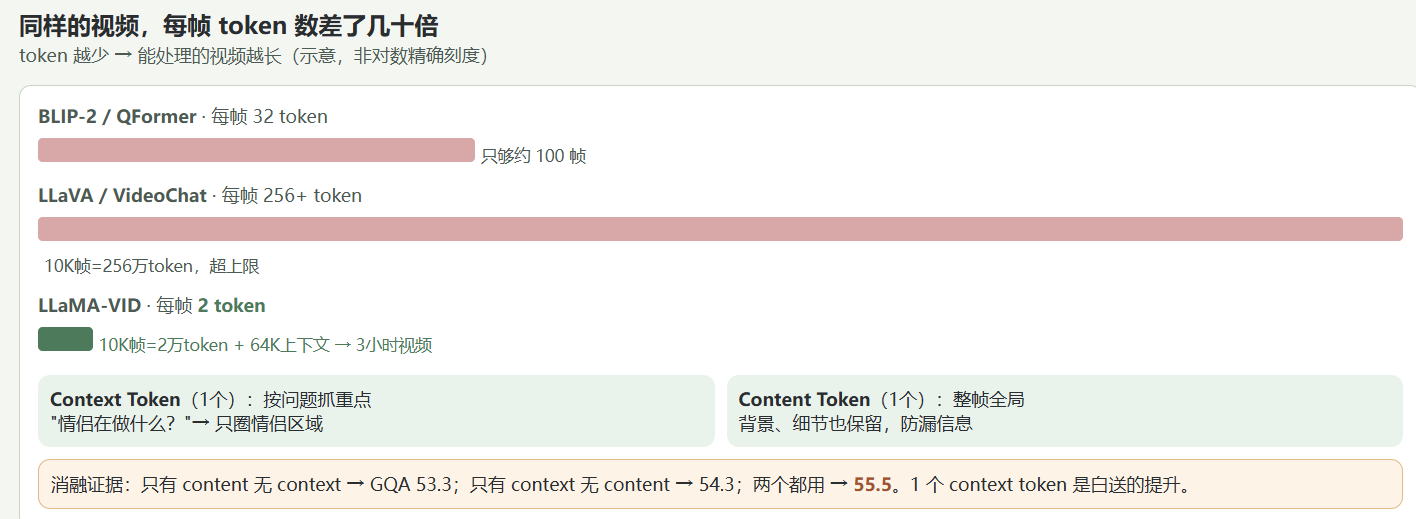
token 数量爆炸:当时的 VLM 每张图要 32(BLIP)到 256+(LLaVA)个 token,一段 1 万帧的视频就是 32 万 + token,超出任何 LLM 的上下文上限;
简单压缩伤长期记忆:粗暴的时间降采样(比如均匀抽帧)会破坏跨长间隔的时序关系,模型答不了 "前面发生了什么";
前人方案都不够:VideoChat、Video-LLaMA 用可学习 query,Video-ChatGPT 用空间 / 时间池化,但每帧 token 仍然太多,都撑不到 1 小时视频。
2.解决问题?
① 双 token 生成策略(核心贡献)
Context Token:用户的指令先进一个文本解码器(BERT 或 Q-Former),生成 "文本查询 Q_t";Q_t 再通过 Context Attention(跨模态注意力)扫描整帧的视觉嵌入,只聚合与问题相关的视觉线索,压成 1 个 token。公式:
E_t = Mean(Softmax(Q_t × X_tᵀ) × X_t)—— 相当于 "按问题去画面里圈重点"。Content Token:对视觉嵌入做自适应池化。视频场景压到 1 个 token(保效率),单图场景保留 n 个(n=(336/14)²=576,与 LLaVA 一致,保细节)。
两者拼接 = 该帧表示 → 线性投影 → 进 LLM。
② 三阶段训练
Stage 1 模态对齐:790K 图文 / 视频字幕对(558K 图 + 232K 视频),只训 context attention 和投影器,冻结视觉编码器 / 文本解码器 / LLM;
Stage 2 指令微调:40K 文本 + 625K 图像 + 98K 视频指令对,放开文本解码器;
Stage 3 长视频微调(可选):用自建的 Long-VideoQA(15K 对:9K 电影 + 6K LongLoRA)微调,并把位置编码用位置插值从 4K 扩展到 64K—— 这是它能吃下 3 小时视频的关键工程手段。
③ 长视频指令数据怎么来(呼应你之前问的 "指令数据") 用 MovieNet 的 400+ 部电影和剧情梗概(synopsis)+ 完整剧本(script),让 GPT-4 / Claude-2 生成三类数据:视频摘要(简 / 详)、情节级 QA(情节理解 + 人物关系)、细节级 QA(剧情推理 + 场景细节),一共约 9K 对。注意:只用了文本(梗概 / 剧本)来生成指令,视频帧本身只做示意—— 这是用 "大模型当老师" 造指令数据的典型做法。
3.成果
4.启发
"每帧 2 token" 证明了极端压缩的可行性:零样本视频 QA 用 2 token / 帧就能超过所有前人,说明大多数视频问答任务的信息冗余度极高 —— 这是你 token 压缩方向最有力的 "压缩率锚点"。但同时 Table 5 显示压到 1 个 content token 要掉 2~6% 分,"压缩率与细粒度能力" 的矛盾是真实存在的,HourVideo 的 tracking/object-retrieval 子任务(模型近乎随机)就是这个问题被放大的样子。
Context Token 是 "白嫖" 的增益:它只多 1 个 token,却让所有基准普涨 —— 因为它是问题引导的注意力压缩(和 Q-Former 同族)。这直接回应你之前问的 "先分析再回答 vs 直接嵌入压缩":LLaMA-VID 的答案介于两者之间 ——不先整体分析视频,而是用问题当 "钥匙" 去压缩,既便宜又相关。MovieChat(无参数合并)和 LLaMA-VID(可学习注意力压缩)正好是这条线的两个极端样本。
长视频真正难点不在编码,在 "记住并定位":LLaMA-VID 靠 64K 上下文(位置插值)硬扛 3 小时,MovieChat 靠记忆机制沉淀 —— 到 MemDreamer(LVBench 90.7)变成 "分层记忆 + 检索"。你调研时可以把这当成一条演进主线:上下文扩展 → 记忆压缩 → 检索增强。
指令数据可以 "用文本生成":Long-VideoQA 只用电影梗概 + 剧本喂给 GPT-4 造 QA,不用看视频 —— 这是造长视频指令数据的低成本套路(代价是 "视觉细节类" 问题造不好,正好被 HourVideo 那种 "必须看画面才能答" 的设计惩罚)。
一个务实提醒:论文里视频实验的 "每帧 2 token" 主要工作在短视频基准(MSVD/MSRVTT/ActivityNet,平均几秒~几分钟)上,3 小时视频只有定性案例。真正把它放到 1 小时级基准(HourVideo/EgoSchema)上会掉多少,论文没给数字—— 这恰恰是你做调研 / 实验时可以补的空白。