1.提出问题?
长视频理解卡在 token 上,前人两条路都有硬伤:
手工流水线派(VideoTree 这类):人写死 "先分段→打字幕→打分→建树" 的流程,再强的底座模型也被框死在流水线里,自主性差,看片中途想 "回去重看某段" 做不到;
静态数据库派(DVD 这类):先把视频每 10 秒切一段,不管和问题有没有关,全部让 MLLM 预分析一遍建库。结果是每段都看,token 烧得飞起(30 分钟视频理论要 398 万视觉 token),而且库是死的,不能根据问题动态调整。
核心痛点:怎么既不把整部片子塞进上下文,又能让模型根据问题动态地、粗到细地去找证据?
2.解决问题?
两大件:
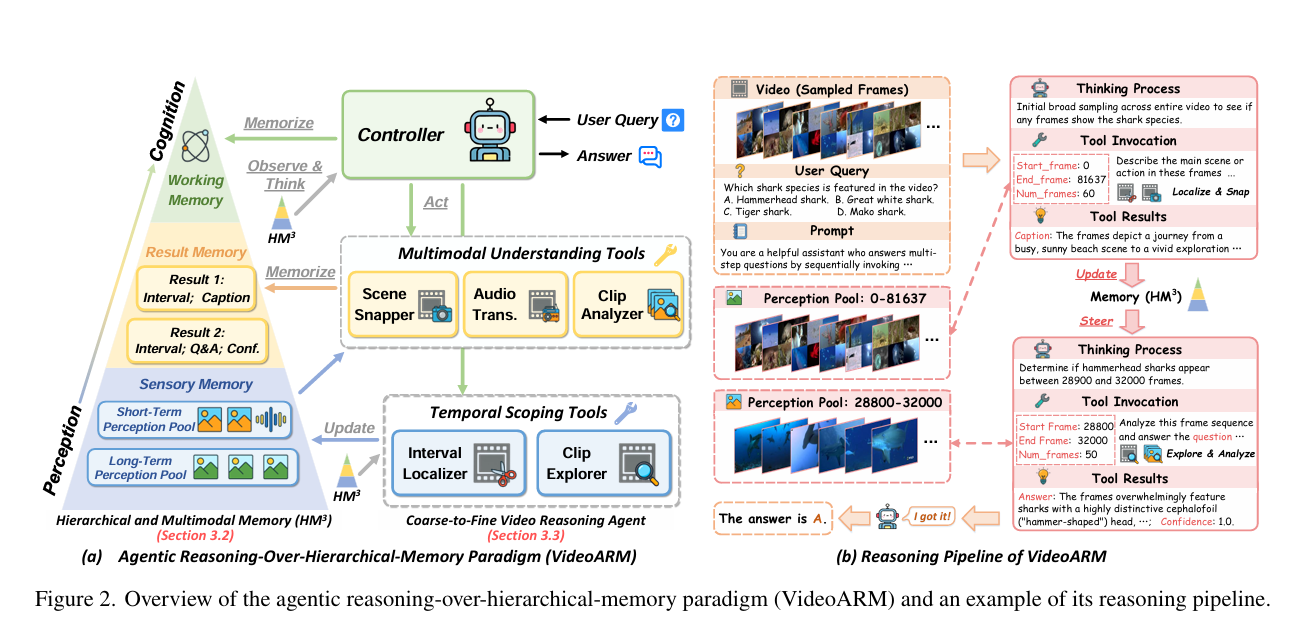
① HM3 分层多模态记忆(三层金字塔)
感觉记忆:长期感知池(当前粗看区间的帧快照)+ 短期感知池(刚凑近查的小段 clip 和音频,用完即清);
结果记忆:按时间记 "第几轮、看了哪段帧区间、工具返回了什么"(含 caption 和带置信度的答案);
工作记忆:存控制器每轮 "我为什么要这么做" 的推理轨迹,用完就从主上下文搬走,防爆炸。
② 粗到细的 Agent 循环(两组工具)
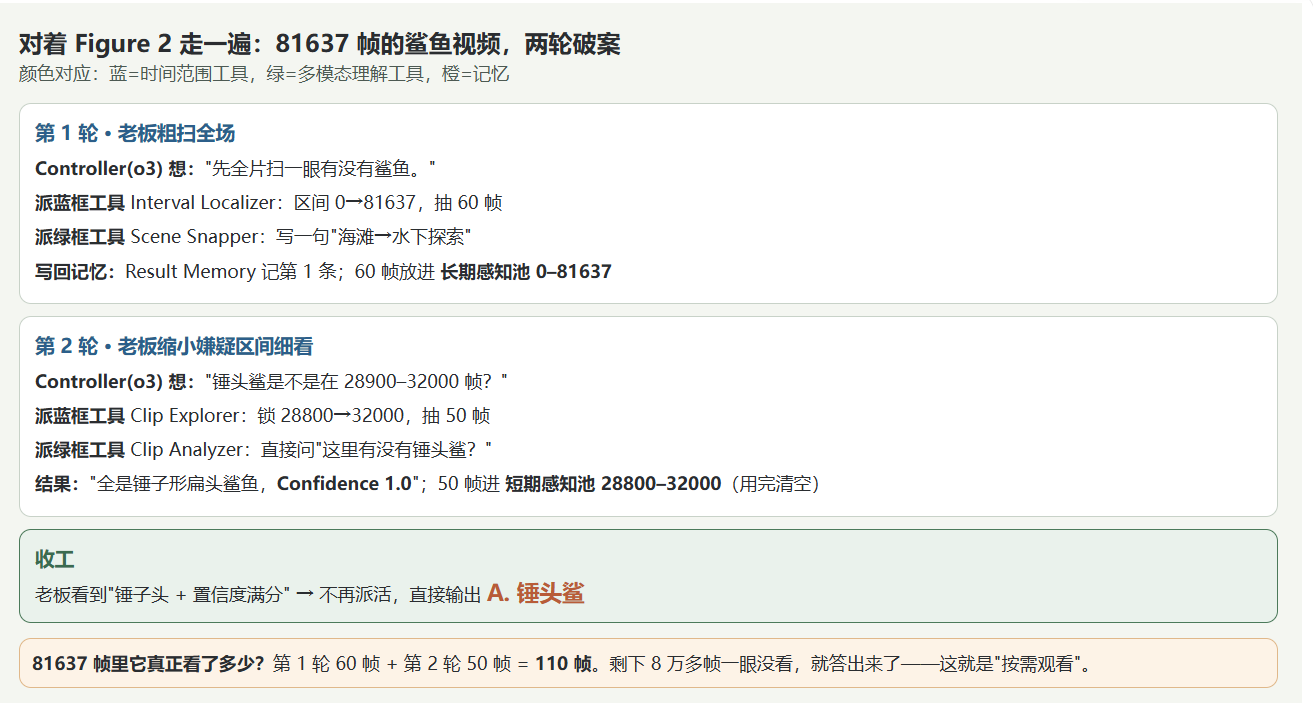
管 "去哪看":Interval Localizer(锁全局区间、抽 30~150 帧拼 3×2 网格)+ Clip Explorer(局部小范围细探,连音频一起存短期池);
管 "看出啥":Scene Snapper(长区间一句话场景描述)+ Audio Transcriber(whisper-1 转写)+ Clip Analyzer(对子问题出答案 +0~1 置信度,供控制器判断要不要继续查)。
控制器走标准 ReAct 循环:Observe→Think→Act→Memorize,没把握就接着查,够了就答,最多 10 步强制收。
3.成果
打榜:Video-MME(w/o sub) Overall 82.8(long 子集 81.2)、LongVideoBench overall 78.0、EgoSchema 76.2、LVBench 79.7、MLVU 81.2;同一底座下全面超过前 SOTA DVD。
token 效率:实测 10 个视频 30 个问题,DVD 烧 6421 万 token,VideoARM 只花 189 万 ——只有 DVD 的 1/34。
可复现性友好:全靠现成 API 拼,代码和 prompt 全公开。
4.启发
开辟了之前调研路线 "正交" 的第三条路:MovieChat/LLaMA-VID 是 "把每帧压成 1~2 token"(embedder 端压缩);VideoARM 干脆不让无关帧进入上下文—— 不压 token,而是少看帧。综述里可以把长视频方案分成两派:压缩派 vs Agent 按需观看派。
好印证了之前那个判断:"先分析再回答" 不适合改视觉 token 本身(会丢信息),但非常适合做观看调度——VideoARM 里 o3 完全不碰视觉嵌入表示,只决定调哪个 API、传哪个帧区间,一次都不丢视觉信息。
三个可抄的设计:① Clip Analyzer 强制输出置信度,把 "我没把握" 显式喂回循环,控制器据此决定停不停;② 每帧左上角打白色全局帧号、拼成 3×2 马赛克,让 LLM 能在拼图里报出帧号,闭环回时间定位;③ 工作记忆把推理轨迹搬出主上下文,本身就是一种上下文级 token 压缩。
它的软肋 = 切入点:论文自承 —— 开局若漏掉 "一闪而过" 的关键事件(遮挡重、只持续几帧),后续没有机制发现 "我一开始就找错了",整条链就废;且重度依赖闭源 o3/GPT-4o,换开源模型掉点明显。"开局找错了能自我纠正" 和 "把这套 agent 循环搬到开源模型上",就是两个现成的改进方向