1.提出问题?
RAG 和视频 agent 路线各有硬伤:
RAG 路线(VideoRAG、AdaVideoRAG):靠孤立的段级 caption 检索,证据是碎片的、缺全局叙事连贯性,跨场景推理差;
视频 agent 路线(VideoAgent、VideoTree、DVD):虽然能动态规划,但底层数据库太简陋(就是帧列表 / 段 caption),要反复多轮检索才能拼出跨段连续证据,又贵又慢;
共同短板:没有一个 "从全局→场景→段→实体" 的统一层级表示,且视觉证据在遮挡 / 切镜头 / 换人机位时会断裂,模型把不同片段里的同一个人当成两个人。
2.解决问题?
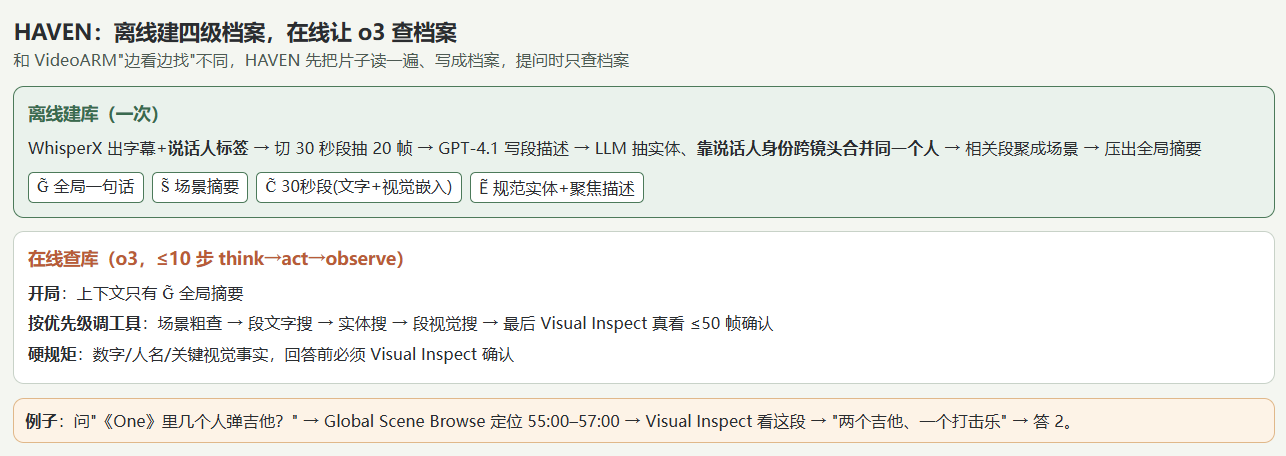
离线建库(一次):
WhisperX 出带时间戳字幕 + 说话人标签;
每 30 秒一段抽 20 帧,GPT-4.1 写段描述(谁 + 说了啥 + 画面啥)+ UNITE 视觉嵌入;
实体两阶段凝聚:文本嵌入层次聚类(阈值 0.4)→ LLM 复查合并 / 拆分;同 speaker label 即使视觉变了也优先合并;每个实体对关联片段写聚焦描述(re-captioning,K1=20/K2=16);
连续相关段聚成场景、写场景摘要,再压出全局摘要 G̃。
在线查库:o3 开局只拿 G̃,循环里按优先级调 5 个工具 ——Global Scene Browse(粗定位)→ Segment Caption Search / Entity Search(文字检索)→ Segment Visual Search(视觉补漏)→ Visual Inspect(最多 50 帧做最终确认);prompt 硬规定 "数字 / 人名 / 关键视觉事实回答前必须 Visual Inspect 验证"。
3.成果
LVBench overall 84.1(2fps 版),推理类 80.1;对比 DVD 74.2、o3 裸跑 57.1、GPT-4o 48.9、Seed1.5-VL 64.6;
Video-MME(long, w/sub) 82.8、LongVideoBench long 78.2、EgoSchema 81.6;
效率:平均 4.2 步 / 98.7 秒每题,DVD 要 7.6 步 / 151 秒;
消融:去掉说话人标签掉 5.3 个点,去掉层级结构掉 8.2 个点,证明两个核心设计都真有用;
开源可复现:DeepSeek-R1-0528 推理 + Qwen3-VL-32B 视觉,LVBench 也能到 75.8。
4.启发
它和 VideoARM 正好是 agentic 路线的两极:VideoARM 在线现看、零预处理;HAVEN 离线建四级档案。你综述里可以加一个维度 "预处理深度"—— 把 GPT-4.1 的贵调用挪到离线一次性做,在线只做便宜的检索和 50 帧确认,片库复用率高时成本明显更优。
"说话人身份当跨镜头胶水" 是个可迁移的点子:视觉会被遮挡 / 切镜头毁,但 voiceprint 不会。你做医疗 / 手术录像场景时,靠 voiceprint 把 "主刀" 这个角色跨镜头串起来,比纯视觉相似度可靠得多。
附录 G 的 prompt 是教科书级别的 agent 工具路由:场景题先粗查、文字找不到再视觉搜、最后必须 Visual Inspect 验证、连续 3 次无果换工具 —— 这套优先级规则你自己写 agent 时可以直接抄。
三个可切入的缺口:① 库是静态的,建完不能根据新问题动态补;② 30 秒固定段粒度拍脑袋;③ speaker diarization 错了整个实体凝聚就错位。这三点都是现成的改进口子