1.提出问题?
现有长视频方法要么 "把整段视频编码成 token 塞进 LLM"(MovieChat/LLaMA-VID 这类)—— 贵、长 context 下注意力稀释;要么 "离线先建四级档案库再在线搜"(DVD/HAVEN 这类)—— 每部新片都要预跑一遍预处理,扩展性差。
工具型 agent 的工具集往往是拍脑袋凑的,缺一个 "到底需要哪些原子能力" 的依据;而且 agent 容易在一道题上死循环、反复调同一个工具直到跑爆预算。
2.解决问题?
数据驱动挖能力分类学:从 MINERVA 人类专家推理轨迹 (Q,R,A,O) 里,用强制 JSON schema(每条能力必须引用原文防幻觉)→ 归一化 + 低频合并 → K-means 86 簇 → 人工审查成 5 大类 22 个原子能力,再据此设计 70 个工具。
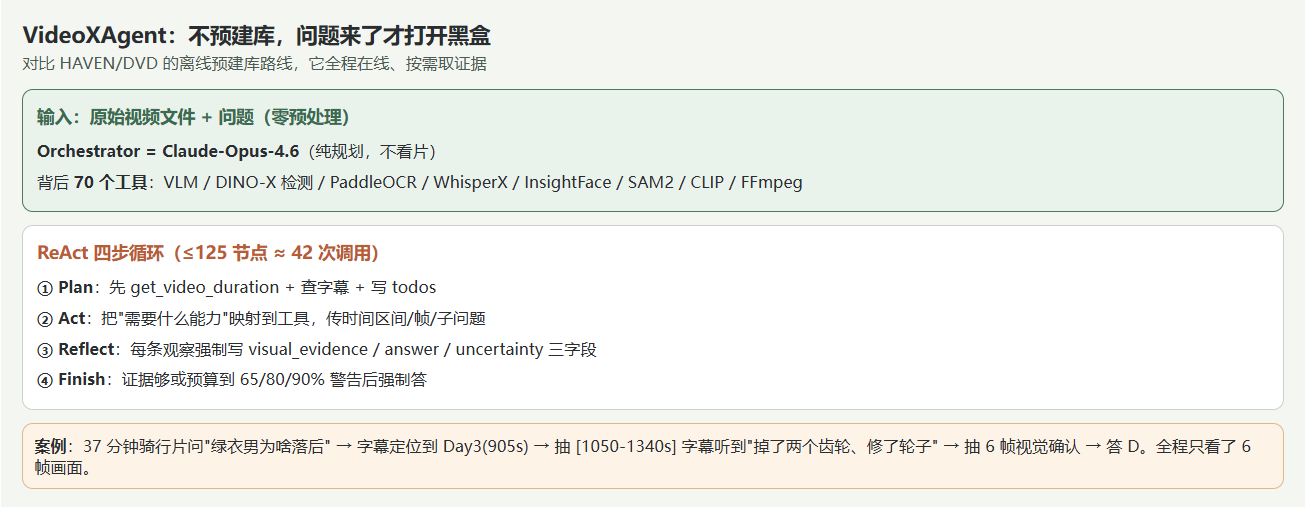
客观证据契约:每个 VLM 工具必须返回
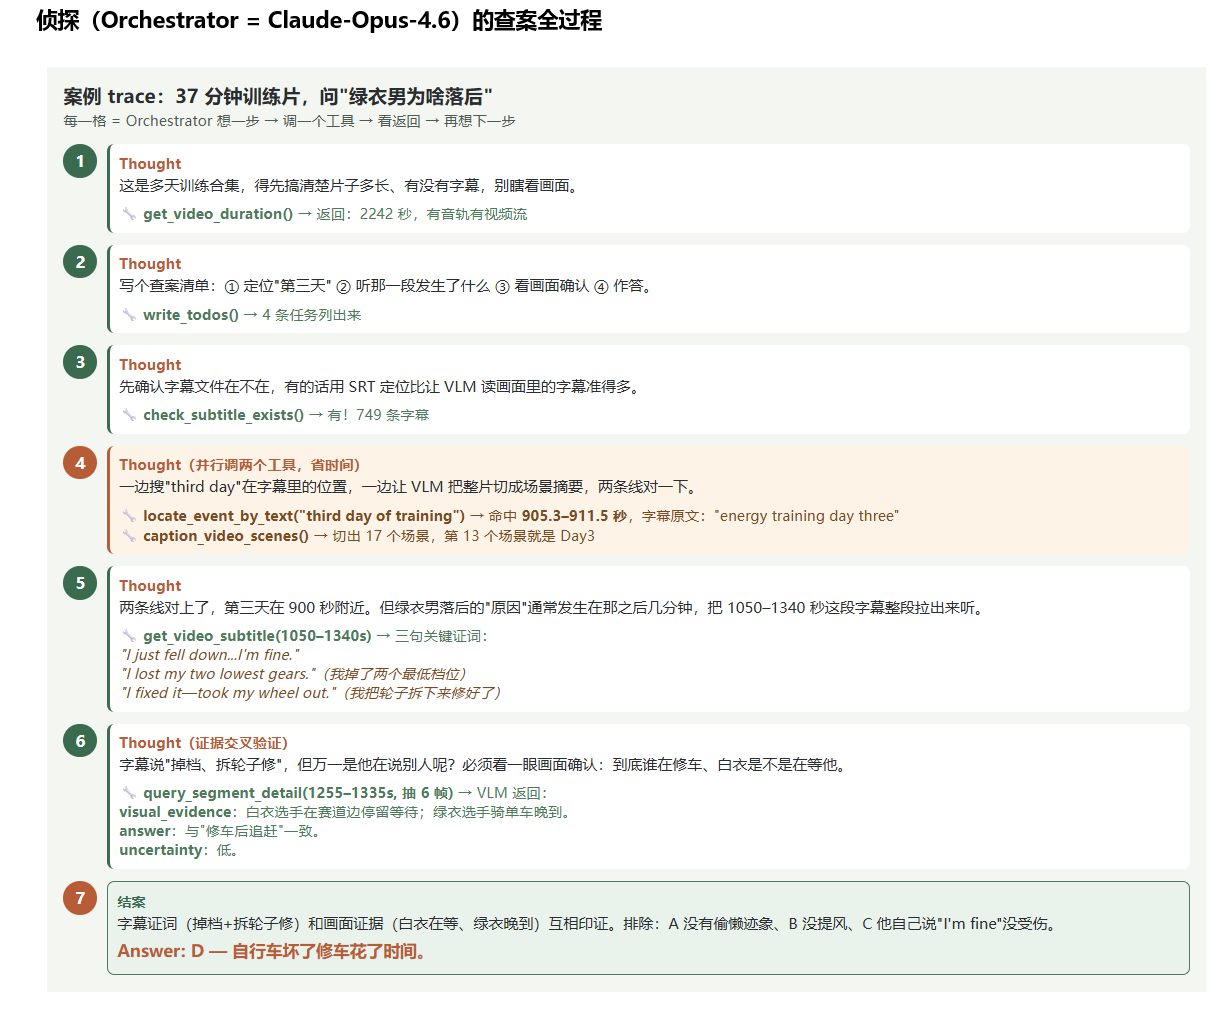
{visual_evidence, answer, uncertainty}三段式,把 "看到的" 和 "猜的" 分开。预算控制防死循环:每题 ≤125 节点(约 42 次调用),用到 65%/80%/90% 注入三级警告,预算耗尽强制
tool_choice=none必须作答 —— 非终止率压到 0%。长度自适应:<60 秒短视频直接整段喂 VLM;长视频 coarse-to-fine,先 sparse 定位再 dense 抽帧。
3.成果
Video-MME-Long 85.1%(52 帧 / 51k context,vs Gemini-3.1-Pro 86.2%/179k、Seed-2.0-pro 85.5%/112k);LongVideoBench-Long 78.1%;LVBench 76.5%;MINERVA 65.7%。
最有冲击力的实验:用纯文本、完全不会看图的 GLM-5.2 当 Orchestrator,视觉全外包给 Qwen3.6 工具,MINERVA 仍达 65.4%—— 证明长视频理解的瓶颈已经从 "模型能不能看图" 转移到 "会不会规划、调工具、处理冲突证据"。
附录 B 从 34364 条轨迹里发现 agent 会自发涌现两条工作流:帧感知循环(缩略图网格→inspect_image)和字幕↔定位循环(get_video_subtitle ↔ locate_event_by_text),没人写死。
4.启发
综述的 agent 路线三代表已经凑齐:VideoARM(在线、5 工具、o3)→ HAVEN(离线预建库、说话人聚类)→ VideoXAgent(纯在线、70 工具、数据驱动挖能力、强预算控制)。可以画一条 "预处理深度 × 工具数量" 的演进线。
纯文本大脑 + 视觉工具这个范式对你做医疗长视频(心磁图 / 手术录像)特别有借鉴:不用养巨型 VLM,养一个会调专用工具的小 LLM 就行。
可切入缺口:① 能力分类学只从 MINERVA 挖的,换医疗 / 工业场景要重新挖;② 70 个工具全是通用视频工具,领域专用工具(ECG 心律、心磁图波形解读)缺位;③ 预算控制靠 prompt 警告,不是可学习的停止策略 —— 这三点都能做。