1.提出问题?
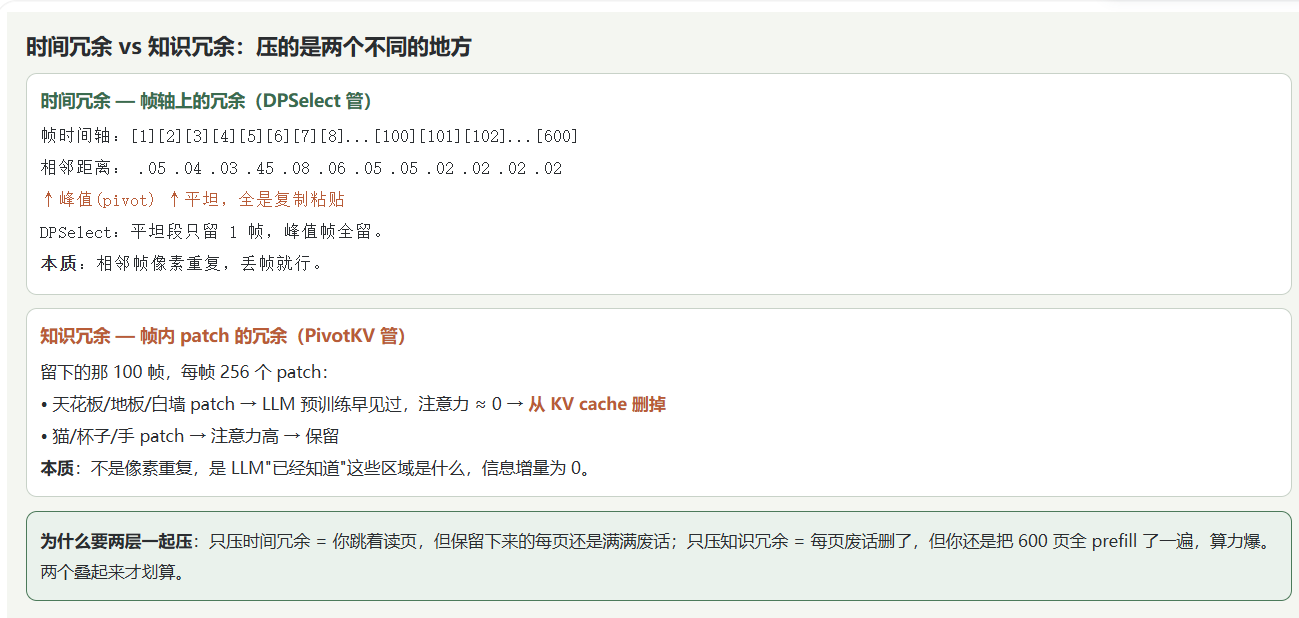
现有长视频压缩(池化、合并相邻 token、Q-Former、MovieChat 记忆整合)只压了低级时间冗余—— 相邻帧像素重复就合并掉。这条路压到一定程度就开始丢真信息。
但还有一种更值钱的冗余没被利用:高级知识冗余—— 保留下来的帧里,天花板 / 白墙 / 地板这种 patch,LLM 预训练早见过了,prefill 时注意力几乎为 0,对回答问题没有信息增量。这种 patch 从 KV cache 里删掉损失极小。
工程上,长视频的瓶颈不是算力而是 KV cache 爆显存(2048 帧 × 256 patch ≈ 200GB),直接加帧数会 OOM。
2.解决问题?
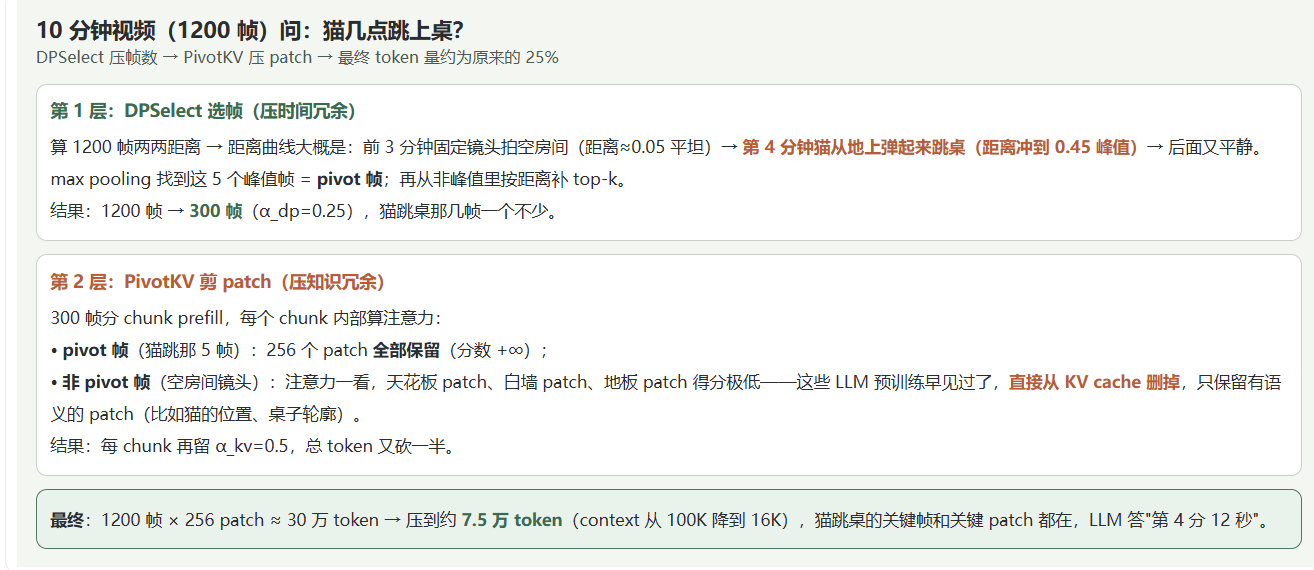
DPSelect(Dist Peak Select)压时间冗余:算相邻帧平均余弦距离,用 max pooling(窗口 3)找距离曲线上的局部峰值标记为 pivot 帧(画面突变的瞬间,灵感来自人脑追踪运动峰值),再按距离 top-k 补够帧。输出二值 mask 告诉后面 "哪些帧不许动"。
PivotKV 压知识冗余:分 chunk prefill,每 chunk 内算注意力矩阵,按所有 head 的注意力和给每个 patch 打分;pivot 帧的 token 分数加 ∞ 全保留,非 pivot 帧只留 top α_kv 的高分 patch,其余从 KV cache 删掉。本质是让 LLM 自己决定哪些 patch 可以扔。
效率优化:用两个 CUDA stream 把 "第 l 层压缩" 和 "第 l+1 层 prefill" 重叠跑,TTFT 只多 8–11%,TPOT 反而降 19–28%。
3.成果
QWen2VL-7B + ReTaKe:VideoMME-Long 56.2、MLVU 69.8、LongVideoBench 57.7、LVBench 47.8(base 42.4,涨 5.4 个点);LLaVA-Video-7B 上同样全面提升。
处理帧数从 256 → 2048(8×),context 压到 16K,在 LVBench 上反超 VideoLLaMA2-72B、LLaVA-OneVision-72B、Oryx-1.5-34B 这些大模型。
对比表打赢 M2SM/A2Summ/FastV/FitPrune/LOOK-M/SparseVLM/PyramidDrop/VL-Cache 一排压缩方法。
关键消融:α_dp/α_kv 最优比在 2~3,说明知识冗余比时间冗余更 "好压";只压时间冗余损失大,必须靠知识冗余补回来
4.启发
补全了 token 压缩图谱的最后一块:transformation-based(无参、压缩比死)→ Q-Former / 蒸馏(要训练)→ 基于注意力的 KV 剪枝(FastV/H2O/SnapKV,所有帧一视同仁)→ ReTaKe(先按运动峰值把帧分两档,pivot 全保留、非 pivot 才按注意力剪)。它的核心洞察是 "不能所有帧一视同仁地按注意力剪"。
和之前那个判断题呼应:你问 "先分析再回答不适合做 token 压缩"——ReTaKe 走了条便宜的中间路:不引入独立 analyzer,而是复用 prefill 本来就要算的注意力矩阵当分析器,零训练开销。这比 VideoXAgent 那种显式调工具的方案更适合端侧推理加速。
可切入缺口:① pivot 帧靠余弦距离峰值,对 "运动小但语义关键" 的镜头(手术中手微抖、ECG 波形细微变化)会漏;② 注意力分数只在 chunk 内部算,没有跨 chunk 全局判断;③ 它是推理期 training-free 压缩,和训练时压缩(比如 DrVideo 那种)正交,可以叠加。