1.提出问题?
token 爆炸:2 小时 720P 视频按 1fps 采样,光视觉 token 就是 1.62M,超出现有上下文窗口。
注意力稀释:硬塞进去之后,关键画面被淹没在几十万冗余 token 里,"lost in the middle",推理能力退化。
端到端模型的推理能力无法迁移:论文统计了 8 个模型在 AIME2025(数学推理)和 LVBench(长视频)上的分数,端到端直接看视频时相关性只有 R=0.70 且不显著 —— 模型越会做数学题,长视频得分并没有跟着涨,被视觉噪声挡住了。
2.解决问题?
核心范式:感知模型和推理模型分开。
阶段一:离线建图(感知模型做,纯文本输出)
流式自适应分段:边看边切,每段 3-8 分钟一个完整故事单元,不按固定窗口硬切。
向下抽子图:每个 Macro Event 展开成小图,节点是实体(人 / 物 / 地点)和微事件(具体动作),边有三种:空间属性(LOCATED_IN)、主谓(PERFORMS)、时序因果(CAUSES/BEFORE)。
向上聚合:三层结构 Video Root → Super Event → Macro Event,跨层用 SUBEVENT_OF 连,跨 Macro 用 LEADS_TO/RESOLVES/CONTRASTS_WITH 连。
存下来全是 JSON,没有一帧原始图。
阶段二:在线检索(推理模型做,ReAct 循环)
7 个工具分三类:
层级导航:GetSummary / GetSuperEvent / GetMacroEvent / GetSubgraph
精确搜索:SearchNodes(语义)/ SearchByTime(时间)
图遍历:GetRelationGraph(沿边多跳)
Observation-Reason-Action 循环,最多 12 轮,每轮只保留 useful_info 作为长期记忆。
3.成果
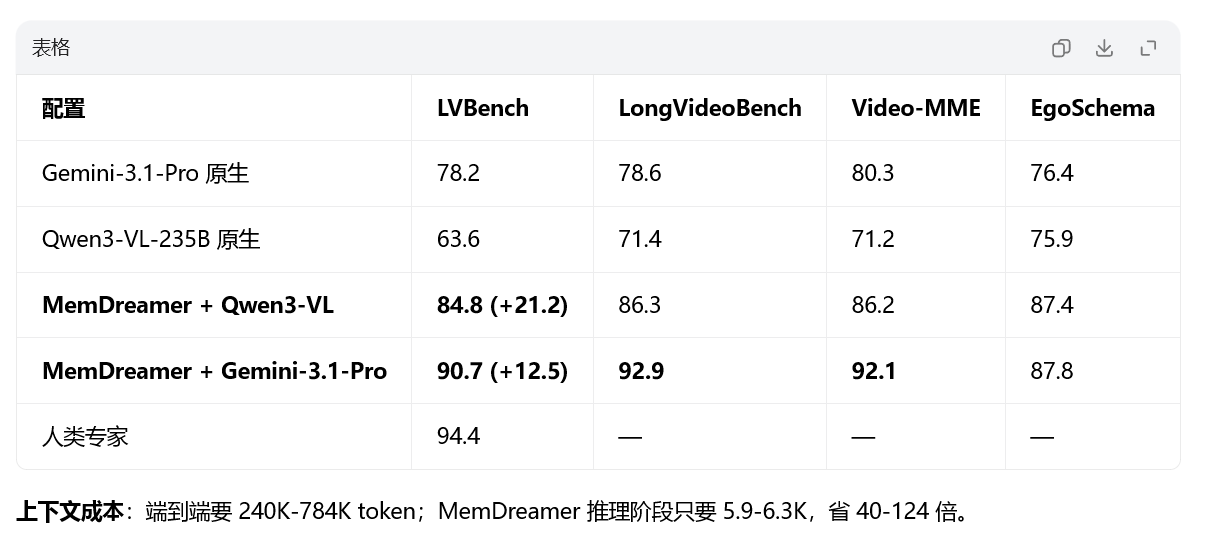
关键消融:
记忆结构:平铺分块 77.4 → 加图 84.8 → 加层级 86.3 → 层级 + 图 90.7(两者互补)
检索方式:朴素向量搜 70.5 → 全塞上下文 78.9 → 只给 Search 80.2 → 全工具 90.7
工具逐个加:图遍历贡献最大(+6.6),层级导航再 +3.9
感知模型换 Gemini-2.5 vs Gemini-3.1,最终只差 0.4-1.4 分 ——感知不用强,强的是推理
最有价值的发现(Table 5):加了 MemDreamer 之后,AIME2025 推理分数和 LVBench 长视频分数的相关性从 R=0.70(不显著)跳到 R=0.90, p=0.003—— 意味着只要把感知和推理解耦,模型的逻辑推理能力可以直接 scale 到长视频上。
4.启发
"塞更多 token" 不是长视频的解。ReTaKe 那种压 KV Cache 还是在 "端到端硬扛" 的范式里修修补补;MemDreamer 直接换赛道 —— 感知和推理解耦后,长视频理解的瓶颈从 "上下文窗口" 变成了 "推理能力",而推理能力是可以 scale 的。
图比平铺有用,因果边最值钱。消融里加图遍历那一步 +6.6 分是单跳最大涨幅,说明跨时间的因果推理("为什么会这样")是平铺摘要给不了的,必须靠边来多跳。
工具集要克制。7 个工具刚好覆盖 "层级下钻 / 语义搜 / 时间搜 / 图遍历" 四类需求,多了反而让模型绕圈子(Tmax=15 反而掉分)。
对你复现的直接参考:附录给了四个完整 prompt(分段 / 子图 / 聚合 / 检索),可以直接抄;感知模型选便宜的就行(论文证明换感知模型只差 1 分),钱要花在推理模型上。
和 HAVEN 对比着看:HAVEN 是 "层级目录 + 文本片段",MemDreamer 是 "层级目录 + 图 + 因果边",多跳推理能力更强;但 MemDreamer 离线建图成本更高,要跑 LLM 把每个 Macro 拆成实体和事件,这是它比 HAVEN 重的地方。